От файла к прототипу
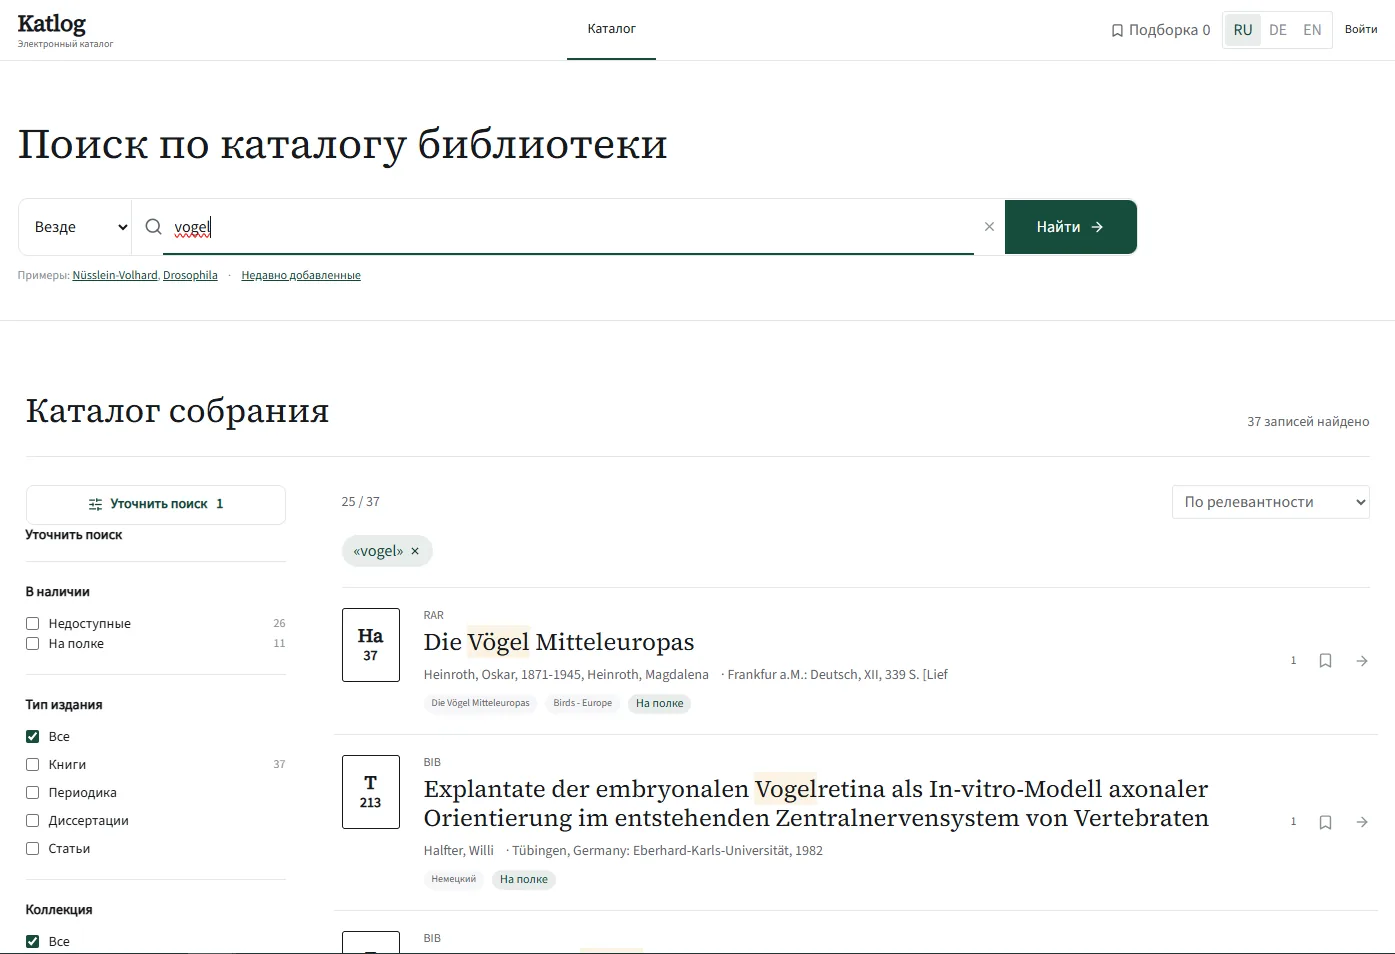
Архив с 6 153 записями лежал на диске. Следующий вопрос: что можно сделать для читателей на основе этих полей? Ответом стал прототип — одна страница, на которой уже можно искать.
После выгрузки у нас был файл JSON — удобный для программ, но бесполезный для читателя. Вопрос для ИИ звучал широко: какие новые возможности можно дать читателям и библиотекарю, если опираться на поля, которые реально есть в записях?
Сначала — изучить данные
Прежде чем рисовать интерфейс, ИИ разобрал структуру записей. Шифры есть у 6 036 записей. Предметные рубрики — у 4 730, всего 4 239 разных. В строках размещения экземпляров нашлись коды фондов (BIB, RAR, REF, MAG) и даты. Из этого стало понятно, какие фильтры имеют смысл, а какие были бы пустыми.
Что попало в прототип
- Мгновенный поиск без учёта регистра и умлаутов.
- Фильтры с живыми счётчиками: наличие, тип, фонд, язык, тема, гистограмма годов.
- Шифр в виде корешка и «Рядом на полке».
- Подборка с выгрузкой в RIS для Zotero и Citavi.
- Три языка интерфейса и нормальная работа на телефоне.
Потом — кабинеты
Каталог без заказов — только витрина. Поэтому следующим шагом стали два связанных кабинета: заказ читателя сразу попадает в очередь заявок, библиотекарь меняет его статус, и читатель это видит. Выдачу и учёт экземпляров мы решили строить заново, не оглядываясь на Aleph.
Зачем нужен прототип, если потом всё пишется заново
Прототип оказался не черновиком, а эталоном. Когда настоящая система, написанная агентом, потеряла половину функций, именно по прототипу мы сверяли, что должно быть: вот так выглядит корешок, так работают фильтры, так устроена карточка. Без него спор «как должно быть» шёл бы по памяти.